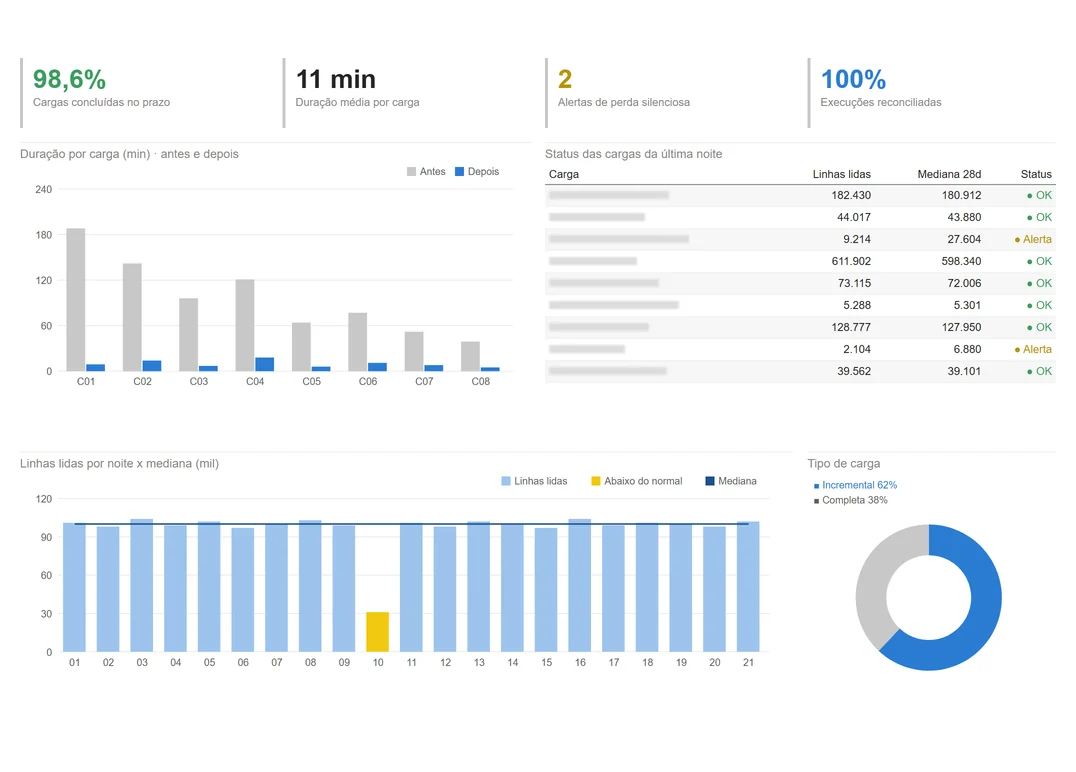
Uma carga que falha aparece no log, dispara alerta e alguém corrige. O problema maior é a carga que termina com status de sucesso depois de ler só uma parte dos dados. O painel atualiza no horário, os números parecem normais, e a diferença só aparece semanas depois, quando alguém compara com outra fonte. Este roteiro mostra como encontrar essas cargas no Pentaho Data Integration e como fazer a próxima falhar de verdade.
1. Entenda por que isso acontece
As causas mais comuns são estas:
- A origem ainda não terminou de ser atualizada quando a carga roda, e a consulta devolve só o que já estava lá.
- Uma API responde com página vazia ou com erro em formato de resposta válida, e a transformação segue como se não houvesse dados.
- O filtro incremental usa uma data de corte errada e deixa um período de fora.
- O tratamento de erro de um passo desvia as linhas com problema e a transformação continua sem avisar ninguém.
- A carga apaga o destino antes de ler a origem. Se a leitura vier incompleta, o destino fica incompleto.
Nenhuma dessas situações gera erro no Pentaho. Por isso, o status da execução sozinho não basta.
2. Grave o log das transformações num banco
Nas configurações de cada transformação, a aba Logging permite gravar uma linha por execução numa tabela de log. Essa linha traz o nome da transformação, o status, as datas de início e fim e os contadores de linhas: LINES_READ, LINES_INPUT, LINES_OUTPUT, LINES_WRITTEN, LINES_UPDATED, LINES_REJECTED e ERRORS.
Para cada contador, dá para escolher qual passo o alimenta. O mais útil é apontar o LINES_INPUT para o passo que lê a origem. Assim, cada execução registra quantas linhas vieram de fato.
Ligue o log em todas as cargas que alimentam painéis, de preferência na mesma tabela. Depois de algumas semanas, você tem o histórico de volume de cada uma.
3. Compare cada execução com as semanas anteriores
Com o histórico gravado, uma view marca as execuções que leram bem menos que o normal. A referência é a mediana das execuções anteriores no mesmo dia da semana, porque muitas bases têm volume menor no fim de semana.
O exemplo abaixo é para PostgreSQL. No Oracle, a função MEDIAN faz o papel do percentile_cont.
create view vw_cargas_suspeitas as
with exec as (
  select transname, id_batch, startdate::date as dia, lines_input
  from log_transformacoes
  where status = 'end'
)
select e.transname, e.id_batch, e.dia, e.lines_input, r.mediana,
       round((e.lines_input / nullif(r.mediana, 0))::numeric, 2) as razao
from exec e
cross join lateral (
  select percentile_cont(0.5) within group (order by h.lines_input) as mediana
  from exec h
  where h.transname = e.transname
    and h.dia between e.dia - 56 and e.dia - 1
    and extract(dow from h.dia) = extract(dow from e.dia)
) r
where e.lines_input < 0.5 * r.mediana;
O limite de 50% é um ponto de partida. Cargas com volume muito estável aguentam um limite mais apertado, e cargas que variam muito pedem um mais folgado.
4. Teste o alerta contra o histórico
Antes de confiar na view, rode-a sobre todo o histórico disponível e compare com os incidentes que a equipe já conhece. Ela precisa apontar esses episódios. Se marcar dezenas de execuções normais, o limite está apertado demais. Se deixar passar um caso conhecido, está folgado demais.
Esse teste também costuma revelar perdas que ninguém tinha percebido. Vale conferir cada uma com a origem antes de ajustar o limite.
5. Faça a carga falhar quando faltar dado
Além de detectar, dá para impedir que a carga grave um resultado incompleto:
- Grave numa tabela de preparação e só troque o destino depois de conferir o volume, numa única transação. Se a conferência falhar, o destino fica como estava.
- Valide o retorno de APIs antes de apagar qualquer dado do destino.
- No job, use a entrada Evaluate rows number in a table para conferir a tabela de preparação e seguir pelo caminho de erro quando o número estiver fora do esperado.
- Reconcilie origem e destino a cada execução: conte as linhas do período nos dois lados e grave o resultado numa tabela própria.
Com isso, uma leitura incompleta vira uma falha no log, com o destino intacto, e a equipe fica sabendo no mesmo dia.
6. Avise alguém todo dia
A view só ajuda se alguém olhar para ela. Um job diário que consulta vw_cargas_suspeitas e manda um e-mail quando houver linhas, pela entrada Mail do próprio Pentaho, já resolve. Se a empresa tem uma ferramenta de monitoramento, a mesma consulta pode virar um alerta lá.
Aplicamos esse método num hospital de grande porte, descrito em Modernização da Engenharia de Dados de um Hospital. Testada contra mais de um ano de histórico, a detecção reproduziu os episódios de perda que já se conheciam.
Suas cargas noturnas são confiáveis? Converse com a Dome.