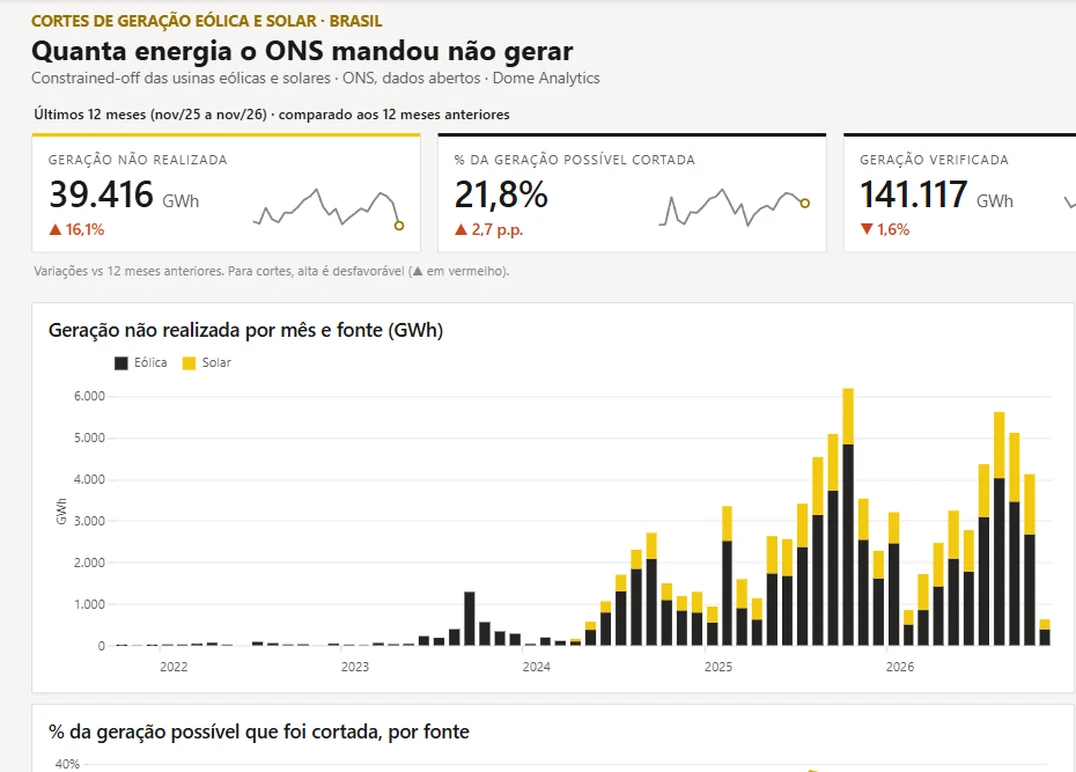
Muitos órgãos publicam dados abertos em arquivos mensais e corrigem esses arquivos depois. O ONS (Operador Nacional do Sistema Elétrico), por exemplo, atualiza o mês corrente duas vezes por dia e regrava meses anteriores: o arquivo de outubro de 2026 dos cortes de geração eólica mudou em 5 de novembro. Uma carga que só baixa o mês novo perde essas correções. Baixar tudo de novo todo dia resolve, mas fica lento quando o histórico passa de 16 milhões de linhas. Este roteiro mostra como recarregar só o que mudou e manter o modelo coerente com a fonte.
1. Descubra até onde a fonte volta
Antes de escrever a carga, observe a fonte por algumas semanas. Guarde a data de modificação de cada arquivo e veja quais meses mudam e com que atraso. No caso do ONS, as mudanças aparecem no mês corrente e nos dois anteriores. Essa janela de três meses passa a ser o que cada execução confere.
Uma janela curta demais deixa correções de fora. Uma janela longa demais só custa tempo de execução, então na dúvida vale começar folgado e encurtar depois de ver o histórico.
2. Use o ETag para saber se o arquivo mudou
Arquivos publicados em buckets como o S3 respondem a uma requisição HEAD com o cabeçalho ETag, que muda quando o conteúdo muda. A carga guarda o ETag de cada arquivo numa tabela de controle e compara antes de baixar:
def cabecalho(url):
    try:
        with urllib.request.urlopen(urllib.request.Request(url, method="HEAD"), timeout=30) as resp:
            return {"etag": resp.headers["ETag"].strip('"'),
                    "bytes": int(resp.headers["Content-Length"])}
    except urllib.error.HTTPError as erro:
        if erro.code in (403, 404):  # mês ainda não publicado
            return None
        raise
Se o ETag for igual ao da última carga, o arquivo fica de fora. Na maior parte das execuções, a carga faz três requisições HEAD por fonte e não baixa nada.
A tabela de controle também ajuda no dia a dia. Com o mês, o ETag, o tamanho, o número de linhas e a hora da carga, dá para responder quando um mês mudou pela última vez sem abrir log nenhum.
3. Troque o mês inteiro numa transação
Quando o arquivo mudou, a carga apaga as linhas daquele arquivo, insere as novas e atualiza a tabela de controle, tudo na mesma transação:
begin;
delete from raw.restricao_eolica where _arquivo = 'RESTRICAO_COFF_EOLICA_2026_10.parquet';
copy raw.restricao_eolica (...) from stdin with (format csv);
insert into raw._cargas (...) values (...)
  on conflict (fonte, arquivo) do update set etag = excluded.etag, linhas = excluded.linhas;
commit;
Trocar o mês inteiro trata um caso que o upsert por chave deixa passar: a linha que a fonte retirou na revisão. Com upsert, ela continuaria no banco. Por causa da transação, quem consulta durante a carga continua vendo o mês antigo até o commit. E rodar a mesma carga duas vezes deixa o banco igual.
Vale também prever colunas novas. Se o arquivo trouxer uma coluna que a tabela não tem, a carga cria a coluna antes de inserir, e a execução segue.
4. Leve a mesma janela para o modelo
Se a carga refaz três meses e o modelo recalcula só o último, as correções param no banco e não chegam ao painel. No dbt, a estratégia microbatch processa a tabela em lotes por período, e o lookback diz quantos lotes anteriores refazer:
{{ config(
    materialized='incremental',
    incremental_strategy='microbatch',
    event_time='dia',
    begin='2021-10-01',
    batch_size='month',
    lookback=2
) }}
No Postgres, o adaptador do dbt grava cada lote com merge pela chave, e o problema do passo anterior volta: uma usina que o ONS retirasse de um mês revisado continuaria na fato. A solução foi uma macro que sobrescreve postgres__get_incremental_microbatch_sql e, para cada lote, apaga o intervalo de datas inteiro antes de inserir. É o mesmo comportamento que os adaptadores de Snowflake e BigQuery já têm.
5. Teste que os totais batem
No projeto, três testes do dbt vigiam essas recargas:
- chave única por usina e dia na fato, para pegar linha duplicada depois de uma recarga;
- soma mensal da fato igual à da staging, para pegar mês que ficou pela metade;
- valores aceitos nos códigos de razão e de origem, para perceber quando a fonte inventa um código novo.
No GitHub Actions, o projeto carrega uma amostra de três dias num Postgres descartável e roda o dbt build duas vezes. A segunda execução já é incremental, e é ela que mostra se o lote refeito deixa os totais iguais.
6. Dispare o modelo quando a carga muda
Com Airflow 3, cada DAG de carga atualiza um Asset que representa a sua tabela no banco, e o DAG do dbt não tem horário: ele roda quando uma das cargas termina. Antes do dbt build, um dbt source freshness confere se as fontes estão em dia. Assim, o modelo roda logo depois de cada carga conferida, sem horário fixo para acertar, e um atraso da fonte aparece como falha no Airflow.
Usamos esse caminho no projeto Cortes de Geração Eólica e Solar, que acompanha a energia que as usinas deixaram de gerar por ordem do ONS desde 2021. O painel em Power BI mostra o resultado, e o código está no GitHub.
Sua carga perde as correções da fonte? Converse com a Dome.