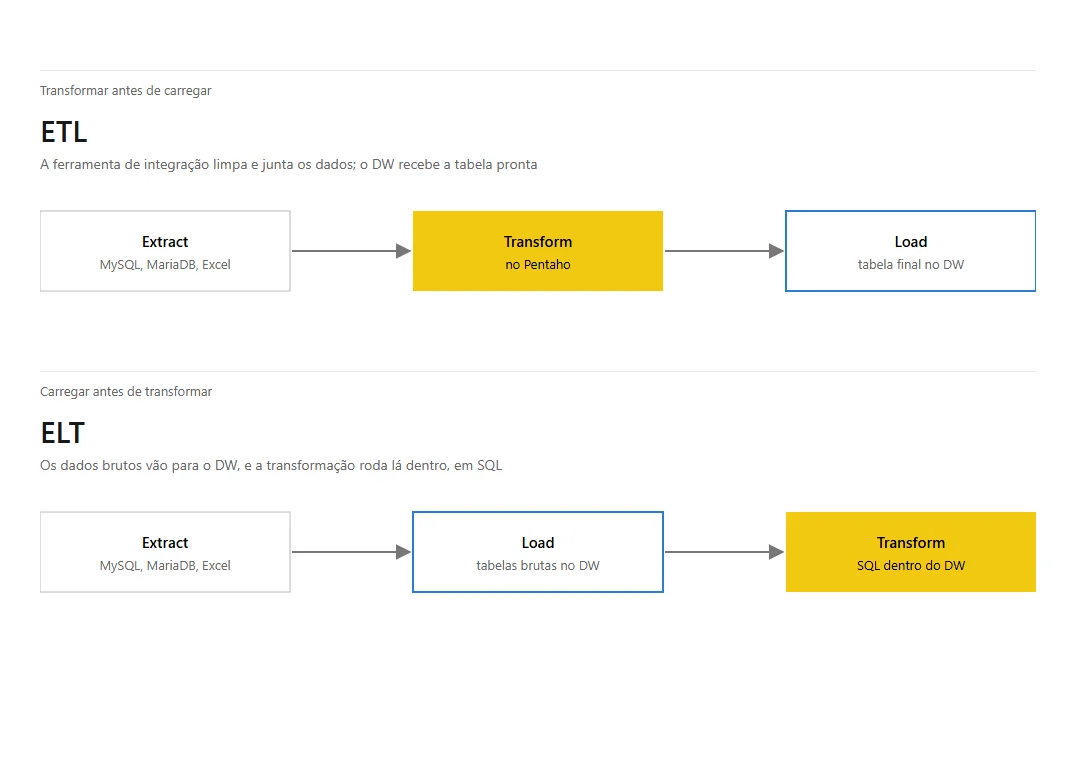
ETL e ELT têm as mesmas três etapas: extrair os dados das fontes, transformar e carregar no Data Warehouse. O que muda é a ordem e o lugar onde a transformação acontece. No ETL, a ferramenta de integração limpa e junta os dados antes de gravar, e o DW recebe a tabela pronta. No ELT, os dados chegam brutos ao DW e a transformação roda lá dentro, em SQL.
Para mostrar a diferença, este artigo usa o pipeline do nosso workshop de Pentaho, que está completo no GitHub e roda no próprio computador com Docker.
O cenário
Três fontes, cada uma de um dono diferente:
- MySQL, o sistema de gestão de pessoas, com a tabela
funcionarios(id, nome e CPF). - MariaDB, o sistema de vendas, com o total vendido por CPF em cada mês.
- Excel, a planilha em que a gestão registra a equipe de cada funcionário.
O objetivo é ter no DW PostgreSQL uma tabela vendas_final com competência, funcionário, equipe e total de vendas. Repare que as fontes não usam a mesma chave: as vendas identificam o funcionário pelo CPF, e a planilha usa o id do cadastro. O cadastro de funcionários é a ponte entre as duas.
Do jeito ETL, no Pentaho
No Pentaho Data Integration, a transformação lê as três fontes, junta tudo na memória e grava só o resultado:
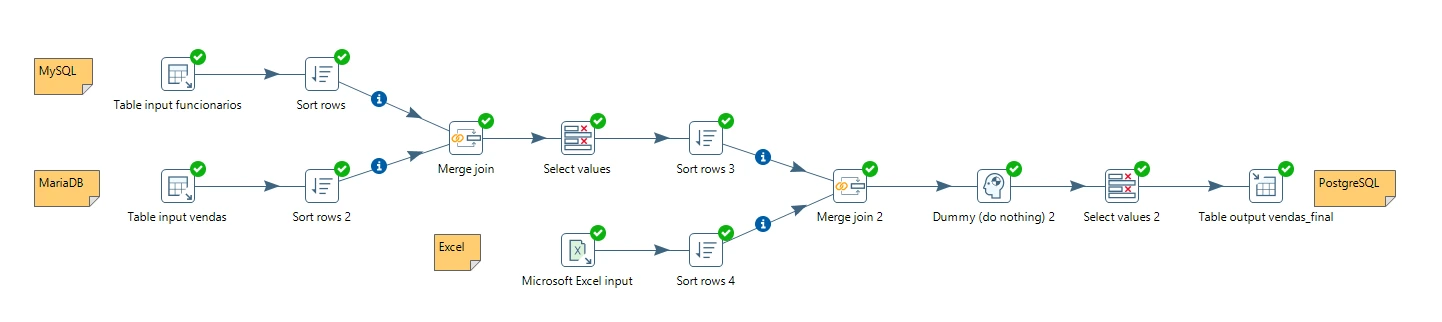
- Dois passos Table input leem
funcionariosevendas, e um Microsoft Excel input lê a planilha. - Cada fluxo passa por um Sort rows. O Merge join do Pentaho só funciona com as duas entradas ordenadas pela chave da junção, e é fácil esquecer essa ordenação.
- O primeiro Merge join liga vendas e funcionários pelo CPF. O segundo traz a equipe pelo id. Os dois usam junção externa à esquerda, para que uma venda sem cadastro apareça com o funcionário vazio em vez de sumir.
- Um Select values escolhe e renomeia as colunas.
- O Table output grava
vendas_finalno DW, esvaziando a tabela antes.
Do jeito ELT, em SQL
No ELT, a primeira tarefa é copiar as fontes para o DW como estão, sem mexer em nada. No PostgreSQL, isso dá três tabelas de preparação: stg_funcionarios, stg_vendas e stg_equipes. A cópia pode ser feita pelo próprio Pentaho, com um Table input e um Table output por fonte, ou por qualquer ferramenta de carga.
Com tudo no mesmo banco, a transformação vira uma consulta:
create table vendas_final as
select v.dt_mes       as competencia,
       f.funcionario  as nm_funcionario,
       e.equipe,
       v.total_vendas
from stg_vendas v
left join stg_funcionarios f on f.documento = v.cpf
left join stg_equipes e      on e.id = f.id;
A consulta não precisa ordenar nada antes da junção, porque o banco cuida disso. As tabelas brutas continuam no DW, então é possível refazer a transformação ou criar outra a partir delas sem voltar às fontes.
Como escolher
O ETL costuma ser a melhor escolha quando:
- o DW é um banco comum, sem folga de processamento para transformar volumes grandes;
- os dados precisam ser limpos ou mascarados antes de chegar ao DW, como CPF e outros dados pessoais;
- a empresa já tem as cargas no Pentaho ou em ferramenta parecida e a equipe conhece bem a ferramenta.
O ELT faz mais sentido quando:
- o DW tem capacidade de sobra, como os bancos em nuvem;
- a equipe sabe SQL melhor do que a ferramenta de integração;
- vale a pena guardar o dado bruto para auditoria ou para criar novas análises depois;
- a transformação muda com frequência e precisa ser versionada, testada e revisada como código.
Na prática, muitas empresas misturam os dois. Um padrão comum é usar o Pentaho só para extrair e carregar as tabelas de preparação e deixar as regras de negócio em SQL dentro do DW.
Cuidados para os dois jeitos
Equipe válida em cada mês
A planilha do exemplo tem uma coluna dt_mudanca, com a data da mudança de equipe, e o pipeline usa só a equipe atual. Se alguém mudar de equipe no meio do ano, todas as vendas antigas vão para a equipe nova. Para corrigir, a junção com a planilha precisa considerar a data: cada venda fica com a equipe válida na competência dela.
Carga completa ou incremental
O exemplo esvazia vendas_final e grava tudo de novo a cada execução. Com poucos dados, isso é simples e seguro. Quando o volume cresce, vale carregar só as competências novas ou alteradas. Seja qual for o método, confira se a carga leu tudo o que devia. O artigo Carga do Pentaho com sucesso e dados faltando: como detectar mostra como.
Senhas fora dos arquivos
O arquivo .ktr guarda a senha de cada conexão. O Pentaho a grava como "Encrypted", mas esse formato só embaralha o texto e qualquer pessoa consegue reverter. Em projeto real, use variáveis no kettle.properties ou no ambiente, e deixe o arquivo da transformação sem senha antes de colocá-lo no controle de versão.
Quer montar ou revisar o pipeline de dados da sua empresa? Converse com a Dome.